
Articoli
Raspberry Pi Imager 2.0
La versione 2.0 rappresenta una riprogettazione completa dell’interfaccia piuttosto che un aggiornamento incrementale e introduce una pratica visualizzazione guidata


Imager è lo strumento ufficiale di scrittura delle immagini sviluppato dalla Raspberry Pi Foundation, pensato per semplificare la preparazione dei supporti di memorizzazione per i dispositivi Raspberry Pi. La versione 2.0 rappresenta una riprogettazione completa dell’interfaccia piuttosto che un aggiornamento incrementale.

La versione 2.0 rappresenta una riprogettazione completa dell’interfaccia piuttosto che un aggiornamento incrementale e introduce una pratica visualizzazione guidata
Le novità in pillole
Introduce un’interfaccia guidata passo per passo che accompagna l’utente attraverso una sequenza di fasi ben distinte, che includono la selezione del modello di Raspberry Pi, la scelta del sistema operativo, l’individuazione del dispositivo di destinazione, la configurazione del sistema, la scrittura dell’immagine e il completamento del processo. Ogni fase occupa l’intera finestra dell’applicazione, offrendo spazio per spiegazioni, messaggi di validazione e informazioni contestuali, riducendo l’affollamento visivo e rendendo più accessibili anche le configurazioni avanzate. Integra inoltre la possibilità di preconfigurare Raspberry Pi Connect durante il processo di scrittura dell’immagine: autenticandosi in questa fase, il dispositivo risulta già collegato al proprio account al primo avvio, consentendo subito l’accesso remoto tramite condivisione dello schermo o shell. L’accessibilità è un elemento centrale della
riprogettazione, con controlli etichettati per i lettori di schermo, navigazione completa da tastiera e più attenzione al contrasto dei colori e alla disposizione degli elementi. La nuova combinazione cromatica e l’uso generoso dello spazio bianco contribuiscono a migliorare la leggibilità e la chiarezza dell’interfaccia, rendendo Imager più fruibile per un pubblico ampio, compresi i novizi.
Leggi anche: “Media Center sulla Raspberry“

Articoli
Svuotare la RAM con criterio
Analizzare l’uso della memoria individua processi che consumano troppa RAM e provocano rallentamenti o uso eccessivo dello swap.

A differenza dello spazio su disco, la RAM non è una risorsa che deve essere mantenuta libera. Nei sistemi Linux moderni la memoria disponibile viene utilizzata in modo aggressivo per migliorare le prestazioni del sistema. Quando applicazioni e servizi non richiedono tutta la RAM installata, il kernel utilizza quella libera come page cache, cioè come area temporanea in cui conservare dati recentemente letti dal disco, riducendo significativamente i tempi di accesso ai file e alle applicazioni utilizzate più spesso. Se gli stessi dati vengono richiesti di nuovo, il sistema può recuperarli direttamente dalla memoria invece di leggerli dal disco, operazione molto più lenta. Per questo motivo è normale che gli strumenti di monitoraggio mostrino una quantità molto ridotta di RAM “libera”: è in gran parte utilizzata come cache. È importante capire che questa non è davvero occupata in modo permanente. Infatti, quando un’applicazione richiede più memoria, il kernel libera automaticamente le pagine di cache meno recenti e le rende disponibili ai nuovi processi. In altre parole, “svuotare” la RAM senza criterio potrebbe rallentare il sistema invece di migliorarlo!
Quando la memoria diventa un problema
Una situazione diversa si verifica quando uno o più processi consumano una quantità eccessiva di memoria nel tempo. Applicazioni mal configurate, servizi che accumulano dati in memoria o programmi con perdite di memoria (memory leak) possono saturare la RAM e costringere il sistema a utilizzare intensivamente lo swap, cioè l’area del disco usata come memoria di emergenza. Quando questo accade, il sistema può diventare sensibilmente più lento, perché le operazioni che normalmente avverrebbero in memoria devono essere trasferite sul disco. Nei computer desktop il sintomo più evidente è il rallentamento delle applicazioni e dell’interfaccia grafica; sui server, invece, possono aumentare i tempi di risposta dei servizi. Per questo motivo è utile controllare periodicamente l’uso della memoria e verificare se qualche processo stia crescendo in modo anomalo. A differenza della cache del filesystem, che viene gestita automaticamente dal kernel, il consumo di memoria da parte dei processi è un indicatore diretto del comportamento delle applicazioni in esecuzione: non trascuratela!
Analisi in tempo reale
Ci sono diversi strumenti per osservare in tempo reale come viene utilizzata la memoria del sistema, distinguendo tra quella usata dai processi, quella impiegata come cache e l’eventuale uso dello swap. Uno dei comandi più semplici è:
free -h
La colonna available che mostra è molto utile perché rappresenta la quantità di memoria che può essere allocata immediatamente senza ricorrere allo swap. Per analisi più dettagliate è possibile utilizzare strumenti interattivi come top o htop, che permettono di osservare i processi in esecuzione e ordinarli in base al consumo di memoria. In top è sufficiente premere il tasto M per ordinare l’elenco dei processi in base alla RAM utilizzata. Htop offre inoltre un’interfaccia più leggibile e permette di filtrare facilmente i processi più pesanti. Un altro strumento utile è vmstat, che fornisce informazioni sul comportamento della memoria virtuale e sullo stato dello swap:
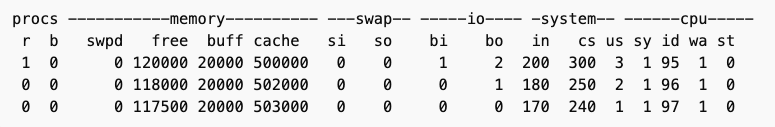
vmstat 5
L’intervallo di aggiornamento (in questo caso 5 secondi) permette di osservare nel tempo l’andamento dell’uso della memoria e l’eventuale attivazione dello swap. L’output sarà simile a quello mostrato qui sotto, con aggiornamenti periodici delle principali statistiche del sistema: stato della memoria, attività dello swap, operazioni di I/O e utilizzo della CPU. Potrete così verificare rapidamente se l’utilizzo della memoria rientra nel comportamento normale del sistema o se indica un problema da approfondire.
Articoli
A caccia di pacchetti e residui di sistema
Individuate facilmente cache, dipendenze inutilizzate e kernel obsoleti in modo da recuperare spazio prezioso.

Durante l’installazione o l’aggiornamento del software, i gestori di pacchetti scaricano gli archivi dei programmi e le librerie necessarie. Li conservano poi nella propria cache per evitare di dover rifare il download in caso di reinstallazioni o aggiornamenti successivi. Nei sistemi basati su Debian e Ubuntu, per esempio, i pacchetti scaricati vengono salvati nella directory /var/cache/apt/archives. Ogni aggiornamento del sistema scarica nuove versioni dei pacchetti dai repository, ma quelle precedenti possono rimanere archiviate nella cache. Anche su sistemi aggiornati regolarmente questo significa che, con il passare dei mesi, la directory può crescere molto. Non è raro, infatti, trovare centinaia di megabyte o diversi gigabyte di file .deb che non sono più necessari per il funzionamento del sistema. APT offre diversi comandi per gestire questa situazione. Il più diretto è:
sudo apt clean
che elimina completamente i pacchetti presenti nella cache. Un approccio più conservativo consiste invece nell’utilizzare:
sudo apt autoclean
che rimuove solo i pacchetti ormai obsoleti, cioè quelli che non sono più disponibili nei repository configurati. Strumenti analoghi esistono anche in altre distribuzioni: dnf clean all nei sistemi Fedora o pacman -Sc nei sistemi Arch permettono di ottenere risultati simili. La pulizia periodica della cache non influisce sul software installato ma può recuperare spazio in modo immediato.
Dipendenze inutilizzate e pacchetti orfani
Un’altra fonte di residui sono le dipendenze installate automaticamente. Quando si installa un’applicazione tramite il gestore di pacchetti, questa porta con sé anche le librerie e i componenti necessari al suo funzionamento. Questo meccanismo semplifica la gestione del software, ma può lasciare nel sistema elementi che non servono più dopo la rimozione del programma principale. Nel tempo possono così accumularsi pacchetti installati come dipendenze ma non più richiesti da alcun software presente nel sistema. Questi componenti vengono spesso chiamati pacchetti orfani o dipendenze inutilizzate. In Debian, Ubuntu e Fedora, le dipendenze non più necessarie possono essere rimosse direttamente dal gestore di pacchetti con il comando autoremove. Il sistema analizza l’elenco dei pacchetti installati automaticamente e rimuove quelli che non risultano più richiesti da alcun software presente. Su Arch Linux i pacchetti orfani possono invece essere individuati con pacman -Qtd. Ridurre il numero di componenti installati non ha effetti solo sullo spazio disco: un sistema con meno pacchetti è anche più semplice da aggiornare.
Kernel vecchi e componenti storici
Molte distribuzioni mantengono anche più versioni del kernel installate, così, se un aggiornamento introduce problemi di compatibilità con hardware o driver, è possibile avviare il sistema con una versione precedente funzionante. Ogni kernel installato include però diversi file: la sua immagine, i moduli caricabili e l’initramfs utilizzato durante l’avvio, che finiscono con l’accumularsi. Nei sistemi Debian e Ubuntu la rimozione dei kernel obsoleti è spesso gestita automaticamente proprio dal comando apt autoremove, che mantiene quella corrente e una precedente per sicurezza. Altrimenti, potete verificare manualmente quali versioni sono installate:
dpkg –list | grep linux-image
Prima di rimuovere manualmente un kernel, però, verificate quale versione è attualmente in uso:
uname -r
Ricordatevi, comunque, di tenere almeno una versione precedente del kernel per poter ripristinare in caso di problemi dopo un aggiornamento.


Un attacco DDoS è, nella sua definizione minima, il tentativo di rendere un servizio indisponibile ai suoi utenti legittimi saturando una risorsa finita. La formula resta volutamente generica, perché la risorsa cambia di volta in volta: può essere la banda del collegamento, la tabella delle connessioni semiaperte del kernel, il numero di processi PHP disponibili, il pool di connessioni verso il database. Quello che accomuna i casi non è il volume del traffico, ma il rapporto tra costo di generazione e costo di elaborazione: chi attacca spende pochissimo per produrre una richiesta che al bersaglio costa molto. Da qui nasce anche l’equivoco più diffuso, cioè l’idea che disporre di risorse elastiche basti a far evaporare il problema.
Due attacchi con lo stesso nome
Sotto la stessa sigla convivono due famiglie che hanno poco in comune. La prima agisce ai livelli 3 e 4: SYN flood, flood UDP e soprattutto attacchi di amplificazione, che sfruttano servizi mal configurati e raggiungibili da Internet (resolver DNS aperti, NTP, istanze memcached esposte) per moltiplicare di decine o centinaia di volte il traffico generato dalla botnet. Qui l’anomalia è evidente e si affronta con criteri di rete: il pacchetto va scartato prima di arrivare al server.
La seconda famiglia agisce al livello applicativo e non ha nulla di anomalo da esibire. Sono richieste HTTP formalmente corrette, con handshake TLS completato, header plausibili e spesso indirizzi residenziali presi in prestito da una botnet domestica. Il volume può fermarsi a poche migliaia di richieste al secondo, un’inezia in termini di banda, purché siano indirizzate agli endpoint giusti: la ricerca interna, il carrello, xmlrpc.php, una query string sempre diversa che rende inservibile qualunque cache. Una richiesta da quattrocento byte può costare al bersaglio una query non indicizzata su una tabella da due milioni di righe.
Valutare un cloud hosting sullo spazio disco e sulla versione di PHP è la parte facile, e le due righe che contano stanno altrove (a quale livello della rete opera il filtro e come viene contabilizzato il traffico in eccedenza). Vhosting, per restare agli operatori italiani, ha costruito la propria infrastruttura su datacenter ridondati in Italia con mitigazione gestita a monte del nodo; altri demandano il compito a un servizio di terze parti da attivare a parte. Sono due modelli diversi e la differenza si apprezza un giorno solo.
Il conto al posto del downtime
L’elasticità funziona, nel senso che fa quello che promette: aggiunge worker, istanze, container. Il punto è che non elimina l’attacco, ne cambia la valuta. Un flood applicativo contro un’architettura che scala non produce più un errore 503, produce una fattura. Il fenomeno ha un nome proprio, EDoS, Economic Denial of Sustainability, e per chi attacca ha il vantaggio di non essere immediatamente visibile: il sito risponde, i grafici del monitoraggio restano verdi, il danno emerge a fine mese.
L’elasticità, per giunta, ha un fondo. Si scalano i frontend con relativa facilità, non altrettanto il livello dati: il pool di connessioni resta un numero finito e, quando i worker appena aggiunti si accodano tutti sullo stesso database, il collo di bottiglia si sposta senza allargarsi. Scalare sotto attacco significa quasi sempre pagare di più per cedere un po’ più tardi.
Dove si ferma davvero
Il traffico ostile va scartato dove eliminarlo costa poco, cioè il più a monte possibile. Una rete anycast disperde il volume su decine di punti di presenza invece di convogliarlo su un singolo collegamento; i centri di scrubbing separano il traffico legittimo da quello di attacco prima che raggiunga l’origine; sul fronte applicativo servono limiti di frequenza per indirizzo e per sistema autonomo, e sfide computazionali che rendono l’attacco costoso anche per chi lo conduce.
Vale la pena conoscere anche la procedura che scatta quando questa catena non c’è. Di fronte a un volumetrico che minaccia il collegamento condiviso, l’operatore di rete a monte annuncia via BGP che il traffico diretto a quell’indirizzo va scartato: è il blackholing, e funziona benissimo. Non protegge il cliente, protegge la rete dagli effetti collaterali del cliente, portando a termine l’attacco con mezzi propri.
Cosa resta al proprio livello
Sul server ci sono comunque interventi sensati, a patto di sapere che filtrare a valle consuma comunque la banda in ingresso. I moduli di rate limiting di Nginx (limit_req, limit_conn) contengono i picchi per client; una cache di pagina intera che risponde senza toccare né PHP né database sposta il tetto di parecchio, perché una pagina servita dalla cache costa tre ordini di grandezza meno di una generata a ogni richiesta; normalizzare o ignorare le query string sconosciute evita che la cache venga aggirata con un parametro casuale; disattivare endpoint legacy come xmlrpc.php toglie di mezzo un bersaglio classico.
Da misurare prima, non durante
Nota pratica: il lavoro utile si fa a freddo. Serve sapere quante richieste al secondo regge il sito con la cache attiva e quante senza, quali endpoint non sono cacheabili per costruzione, e a chi va inoltrata la richiesta di mitigazione — con i contatti del provider annotati da qualche parte che non sia il sito stesso, che durante un attacco è esattamente la cosa che non risponde.

La sicurezza di un progetto online non dipende soltanto dalla qualità del codice o dall’affidabilità del servizio di hosting. Un sito può funzionare perfettamente dal punto di vista dell’utente e, allo stesso tempo, presentare vulnerabilità di sicurezza che potrebbero essere sfruttate per accedere a informazioni riservate, modificare contenuti o compromettere l’intera infrastruttura.
Verificare periodicamente lo stato di sicurezza permette di individuare eventuali problemi prima che possano trasformarsi in incidenti. La verifica dovrebbe riguardare sia l’applicazione web sia il server, il CMS, i plugin, i database e le modalità con cui vengono gestiti gli accessi. Un’attività di controllo ben strutturata può quindi diventare una componente essenziale della gestione del sito web, soprattutto per portali aziendali, e-commerce e servizi che raccolgono dati degli utenti.
Conoscere i principali punti deboli di un sito
Una verifica efficace dovrebbe partire dalla comprensione delle aree nelle quali possono comparire problemi. Le vulnerabilità possono dipendere da errori nella programmazione, configurazioni non corrette, componenti non aggiornati o sistemi di autenticazione insufficientemente protetti. Anche un sito relativamente semplice può essere esposto se utilizza un software obsoleto o dispone di funzionalità non configurate correttamente.
Particolare attenzione merita la gestione degli input forniti dagli utenti, ad esempio attraverso moduli di contatto, campi di ricerca, aree riservate e sistemi di login. Una validazione insufficiente dei dati può aumentare il rischio di attacchi rivolti all’applicazione.
Altrettanto rilevante è la gestione delle credenziali. Password deboli, account amministrativi non più utilizzati e assenza di sistemi di autenticazione aggiuntivi possono ampliare la superficie di attacco. Una buona analisi parte quindi dalla mappatura delle funzionalità disponibili e dalla valutazione dei potenziali punti di ingresso.
Aggiornamenti e configurazione rappresentano il primo controllo
CMS, plugin, temi, librerie e componenti del server dovrebbero essere mantenuti costantemente aggiornati. Le nuove versioni di un software non introducono soltanto funzionalità, ma possono contenere correzioni relative a vulnerabilità scoperte dopo la pubblicazione delle versioni precedenti.
Un sito realizzato con WordPress, Joomla, Drupal o altri CMS richiede quindi una particolare attenzione agli aggiornamenti di sicurezza. La presenza di un plugin abbandonato dal suo sviluppatore può costituire un rischio anche se tutte le altre componenti sono aggiornate.
La configurazione del server merita la stessa attenzione. Permessi dei file troppo permissivi, directory accessibili senza necessità, servizi inutilizzati lasciati attivi e messaggi di errore eccessivamente dettagliati possono fornire informazioni utili a un potenziale aggressore. Anche la corretta implementazione del certificato HTTPS e delle impostazioni del server contribuisce a ridurre il rischio.
Utilizzare uno scanner per individuare possibili vulnerabilità
L’analisi manuale rimane preziosa, ma può essere affiancata da strumenti automatici capaci di esaminare numerosi elementi del sito in tempi relativamente brevi. Un vulnerability scanner analizza l’applicazione alla ricerca di configurazioni problematiche, componenti esposti e comportamenti che potrebbero indicare la presenza di falle.
In questo ambito esistono diversi software diventati standard di fatto per l’analisi della sicurezza. Strumenti come OWASP ZAP e Burp Suite agiscono come proxy di intercettazione, consentendo di analizzare e modificare il traffico HTTP/HTTPS in tempo reale per individuare falle logiche e vulnerabilità come SQL Injection o Cross-Site Scripting (XSS). Per controlli più rapidi e mirati sul web server, utility da riga di comando come Nikto permettono di scansionare automaticamente configurazioni errate, file pericoli e software obsoleti, mentre tool quali Nuclei sfruttano template personalizzabili per identificare CVE recenti su larga scala.
Tra i servizi gratuiti disponibili spicca ZAPScanner, uno strumento sviluppato dal gruppo tedesco binsec che automatizza l’analisi della superficie di attacco basandosi sul motore open source OWASP ZAP. Per garantire un utilizzo etico e sicuro, la piattaforma richiede l’autenticazione dell’utente e l’inserimento di un record DNS TXT sul dominio target per autorizzare esplicitamente la scansione. Questo approccio permette di identificare in modo sistematico le vulnerabilità dell’applicazione web senza eseguire attacchi distruttivi non autorizzati.
Il risultato di una scansione deve comunque essere interpretato con attenzione. Gli strumenti automatici possono produrre segnalazioni che richiedono ulteriori verifiche prima di essere considerate problemi reali. Per questo motivo è opportuno analizzare ogni elemento rilevato, stabilirne il livello di gravità e intervenire prima sulle vulnerabilità che presentano il rischio maggiore.
Controllare accessi, password e privilegi
La protezione dell’area amministrativa rappresenta uno degli aspetti centrali della sicurezza di un sito. Gli account dovrebbero essere concessi soltanto alle persone che ne hanno realmente necessità, applicando il principio del privilegio minimo. Un collaboratore incaricato esclusivamente della pubblicazione dei contenuti, ad esempio, non dovrebbe necessariamente disporre degli stessi permessi dell’amministratore del sistema.
Le password devono essere sufficientemente lunghe, difficili da prevedere e differenti da quelle utilizzate su altri servizi. Nei sistemi che lo consentono è consigliabile attivare anche l’autenticazione a due fattori, soprattutto per gli account dotati di privilegi elevati.
Occorre verificare periodicamente anche l’elenco degli utenti registrati. Account appartenenti a ex collaboratori o profili creati temporaneamente e successivamente dimenticati possono rappresentare punti di accesso non più necessari. Una corretta gestione dei privilegi riduce sensibilmente le possibilità che una singola credenziale compromessa consenta un accesso esteso all’infrastruttura.
Verificare backup, log e sistemi di monitoraggio
Prevenire un attacco è l’obiettivo principale, ma nessun sistema può essere considerato completamente immune da problemi. Per questa ragione una strategia di sicurezza dovrebbe includere procedure che consentano di individuare rapidamente comportamenti anomali e ripristinare il servizio in caso di necessità.
I log di sistema possono fornire indicazioni preziose su tentativi di accesso ripetuti, richieste sospette, errori insoliti o modifiche non autorizzate. La loro analisi permette di riconoscere segnali che una semplice visita al sito non renderebbe visibili.
Anche i backup devono essere sottoposti a verifiche. Non basta creare periodicamente una copia dei file e del database: occorre assicurarsi che sia completa, accessibile e realmente utilizzabile per un eventuale ripristino. Conservare almeno una copia separata dall’infrastruttura principale aumenta inoltre la resilienza del sito nel caso in cui il server venga compromesso.
Rendere i controlli di sicurezza un’attività periodica
Una scansione effettuata una sola volta offre soltanto una fotografia del sito in un determinato momento. Nuovi plugin, modifiche al codice, aggiornamenti del server e funzionalità aggiunte possono introdurre successivamente ulteriori punti deboli. La verifica delle vulnerabilità dovrebbe quindi essere integrata nelle normali attività di manutenzione.
La frequenza dei controlli può variare in funzione della complessità del progetto. Un sito aziendale che viene modificato raramente presenta esigenze differenti rispetto a un e-commerce aggiornato quotidianamente o a una piattaforma che gestisce migliaia di utenti. In tutti i casi, programmare controlli periodici permette di accorciare il tempo che intercorre tra la comparsa di un problema e la sua individuazione.
L’approccio più efficace combina aggiornamenti, configurazioni corrette, scansioni automatiche, verifiche manuali, monitoraggio e procedure di ripristino. La sicurezza informatica diventa così un processo continuo e non un intervento occasionale eseguito soltanto dopo la comparsa di un problema.
Articoli
Recuperate spazio con i log di sistema
Analizzate lo spazio occupato, ripulite il journal di systemd e configurate la rotazione automatica per evitare accumuli inutili.

Per mantenere un sistema pulito è importante controllare regolarmente i log. Nelle distribuzioni moderne i messaggi possono trovarsi sia nei file testuali sotto /var/log sia nel systemd journal gestito da journald, quindi lo spazio occupato non è concentrato in un solo punto. La directory /var/log resta comunque il primo luogo da ispezionare. Qui vengono salvati, a seconda della distribuzione e dei servizi installati, i log del kernel, dell’autenticazione, del gestore di pacchetti, del server grafico o dei demoni di rete. Alcuni file sono attivi, altri sono archivi già ruotati e compressi. Per individuare rapidamente dove si concentra l’occupazione, conviene misurare la dimensione delle sottodirectory e dei file più pesanti, per esempio con:
sudo du -sh /var/log/*
Se emerge una crescita anomala, è bene verificare se dipende da un servizio che sta producendo errori in modo continuo, da un debug rimasto attivo o da una configurazione troppo permissiva. La logica corretta non è cancellare alla cieca, ma capire quali componenti stanno generando dati e se quei dati hanno ancora utilità operativa. Un file enorme in /var/log non è solo un problema di spazio: spesso indica un malfunzionamento o una configurazione da correggere.
Journald: capire quanto occupa e come ridurlo
Nei sistemi che usano il sistema di init systemd, journald raccoglie eventi del kernel, dei servizi e di molte componenti dell’avvio e della gestione ordinaria. A differenza dei log testuali classici, usa un formato binario interrogabile con journalctl. Prima di intervenire conviene usare:
journalctl –disk-usage
che restituisce la dimensione complessiva dei file del journal e permette di capire effettivamente se l’archivio è diventato un candidato reale per la pulizia. Per ridurne l’ingombro senza azzerarlo esistono due approcci molto utili. Il primo è basato sull’età dei messaggi:
sudo journalctl –vacuum-time=7d
In questo modo vengono mantenuti solo gli eventi degli ultimi sette giorni. Il secondo è basato sulla dimensione totale del journal:
sudo journalctl –vacuum-size=500M
Qui il journal viene ridotto fino a occupare al massimo 500 MB. Sono due strategie diverse e vanno scelte in base all’uso del sistema. Su una workstation personale può essere sensato conservare soltanto pochi giorni di cronologia; su una macchina usata per test, sviluppo o amministrazione di servizi conviene spesso ragionare in termini di spazio massimo, così da preservare una quantità sufficiente di storico senza lasciare che la crescita diventi incontrollata.
C’è poi da fare una distinzione importante tra log persistenti e log volatili. Se il sistema salva il journal in /var/log/journal, i dati restano disponibili anche dopo il riavvio. Se invece questa directory non viene usata, il journal può essere mantenuto solo in memoria o in aree temporanee e quindi andare perduto alla successiva accensione. La modalità persistente è preziosa per la diagnosi, ma proprio per questo richiede più attenzione nella
gestione dello spazio.
Evitare che i file crescano senza limite
Logrotate gestisce la rotazione dei log testuali tradizionali. Quando un file raggiunge determinate dimensioni o età, viene archiviato, rinominato, spesso compresso e sostituito da un nuovo file attivo, evitando che i log crescano indefinitamente. La configurazione globale si trova normalmente in /etc/logrotate.conf, mentre le regole specifiche per i singoli servizi sono raccolte in /etc/logrotate.d/. È utile verificare queste impostazioni soprattutto quando un servizio genera grandi quantità di log o quando delle applicazioni aggiungono nuovi file senza una politica di rotazione adeguata. Delle configurazioni troppo conservative possono accumulare molti archivi compressi, mentre delle impostazioni troppo aggressive rischiano di eliminare informazioni utili per il troubleshooting. Ricordatevi che logrotate e journald svolgono funzioni diverse e complementari: il primo gestisce i file testuali in /var/log, il secondo l’archivio binario del journal. Per mantenere sotto controllo l’uso dello spazio vanno quindi considerati entrambi.
Da sapere
Se il journal tende a crescere troppo, conviene intervenire anche in modo permanente modificando /etc/systemd/ journald.conf. Le direttive più utili sono quelle che impongono un tetto allo spazio usato, come per esempio SystemMaxUse, oppure limiti dedicati ai soli dati persistenti e volatili. Dopo la modifica è necessario riavviare il
servizio con: sudo systemctl restart systemdjournald.
Evitate così di dover ricorrere periodicamente a pulizie manuali e rendete prevedibile la crescita del journal, specie sui sistemi con partizioni piccole o con SSD da preservare.
*Illustrazione progettata da Magnific
Articoli
Recuperare spazio su disco
Strumenti e tecniche per individuare rapidamente directory e file che occupano più spazio e mantenere il filesystem sotto controllo.
Se lo spazio disponibile inizia a diminuire, prima di tutto bisogna verificare quale filesystem sta effettivamente raggiungendo la saturazione. Nei sistemi Linux moderni il disco è spesso suddiviso in più filesystem montati in punti diversi dell’albero delle directory: /home può trovarsi su una partizione separata, alcune directory possono essere montate su volumi dedicati e gli ambienti di sviluppo o i container possono utilizzare mount point aggiuntivi. Prima di analizzare le singole directory è quindi necessario ottenere una panoramica della situazione. Il comando più semplice per questa verifica è df, che mostra lo spazio totale e quello utilizzato nei filesystem montati. Utilizzato con l’opzione -h restituisce dimensioni espresse in unità leggibili come megabyte o gigabyte.
La distribuzione dello spazio nelle directory
Il passo successivo consiste nel capire come lo spazio è distribuito tra le directory. Per questa operazione lo strumento principale è du (disk usage), che calcola la dimensione dei file e delle directory presenti in un determinato percorso. Usare:
du -sh *
produce un riepilogo delle dimensioni dei file e delle directory di primo livello e permette di individuare immediatamente quelle più grandi. Quando si analizza un filesystem molto grande può essere utile limitare la profondità della scansione con:
du -h –max-depth=1 /
In questo modo du calcola la dimensione delle directory immediatamente contenute in /, senza analizzare in dettaglio tutti i sottolivelli. Il comando fornisce quindi una panoramica rapida delle aree del filesystem che occupano più spazio, permettendo di ripetere l’analisi solo nelle directory più rilevanti. Spesso si usa anche:
du -h –max-depth=1 / | sort -h
per ordinare immediatamente le directory per dimensione.
Strumenti più evoluti
Quando la struttura delle directory diventa ampia o molto ramificata, l’analisi dello spazio con du richiede di ripetere il comando più volte scendendo progressivamente nell’albero delle directory, impiegando molto tempo. In questi casi è più efficace utilizzare strumenti progettati specificamente per l’analisi dello spazio disco, come ncdu, che esegue una scansione ricorsiva del filesystem e presenta i risultati in un’interfaccia testuale navigabile ordinata per dimensione.

Se preferite iniziare con una GUI, Disk Usage Analyzer (Baobab) esegue una scansione del filesystem e rappresenta l’utilizzo dello spazio con grafici circolari navigabili. Svolge in forma grafica un lavoro simile a quello ottenuto con strumenti come du o ncdu.
Scegliere tra NCDU, GDU E DUST
GDU (Go Disk Usage) è un analizzatore dello spazio disco scritto in Go e progettato per essere veloce anche nella scansione di directory molto estese, sfruttando tecniche di elaborazione parallela. Come NCDU, offre un’interfaccia interattiva nel terminale che consente di esplorare le directory ordinate per dimensione e di spostarsi rapidamente nei livelli più profondi dell’albero. La creazione più recente e l’uso di thread multipli rendono spesso la scansione più
rapida su dischi di grandi dimensioni o su sistemi con molti file. Un approccio diverso è quello adottato da DUST, uno strumento scritto in Rust che privilegia la visualizzazione sintetica e immediata dell’uso del disco. Invece di proporre una navigazione interattiva completa, crea una rappresentazione grafica direttamente nel terminale sotto forma di grafico a barre, che mostra le directory più pesanti della posizione analizzata. La scelta dello strumento dipende dal tipo di analisi che volete effettuare. NCDU rimane una soluzione molto diffusa quando si desidera un’interfaccia semplice e stabile per esplorare il filesystem direttamente dal terminale. GDU è spesso preferibile quando la velocità di scansione diventa critica, mentre DUST è particolarmente utile per ottenere rapidamente una panoramica visiva delle directory più grandi prima di procedere con un’analisi più dettagliata. A voi usarli al meglio.
Articoli
I database degli exploit
Vediamo in rassegna i migliori servizi che monitorano le vulnerabilità per garantire la sicurezza.

Nel vasto e variegato panorama della sicurezza informatica, sono numerose oggi le piattaforme che supportano i professionisti IT, gli analisti e gli appassionati nel monitoraggio costante delle vulnerabilità più recenti.
PIATTAFORME ONLINE
Tra queste possiamo citare senza dubbio CVE Detail, disponibile su https://www.cvedetails.com/, un portale che offre un database completo basato sulle informazioni CVE (Common Vulnerabilities and Exposures). Il servizio raccoglie e organizza in modo dettagliato dati sulle vulnerabilità, corredandoli con avvisi, exploit, strumenti correlati e perfino modifiche al codice sorgente. Una risorsa preziosa per chi si occupa di analisi o di gestione del rischio informatico. Altro strumento utile, da citare è CVE Notifier (https://github.com/0xd3vil/CVE-Notifier), un nuovo progetto open source che fornisce un sistema di monitoraggio e allerta automatica delle nuove vulnerabilità. Gli utenti possono configurarlo per ricevere notifiche mirate relative a specifici vendor o prodotti, con avvisi tempestivi inviati su canali come Slack.

La banca dati ufficiale del governo USA, raggiungibile all’indirizzo https://nvd.nist.gov/vuln/search, mostra le ultime CVE individuate e consente di inserire il numero specifico delle vulnerabilità.
La possibilità di integrare facilmente il sistema nei propri progetti, grazie al codice sorgente e alle guide disponibili, lo rende una soluzione flessibile e adatta a contesti professionali diversificati. A livello istituzionale, un punto di riferimento per il contesto nazionale è il servizio Alert e Bollettini di CSIRT Italia (https://www.acn.gov.it/portale/csirt-italia/alert-e-bollettini). Questa piattaforma ufficiale, gestita dall’Agenzia per la Cybersicurezza Nazionale, pubblica con regolarità aggiornamenti, analisi tecniche e raccomandazioni pratiche per mitigare le vulnerabilità più gravi che interessano infrastrutture critiche e pubbliche amministrazioni. Tra le iniziative più recenti e orientate alla comunità, c’è da citare poi CVE Enrichment di Red Hot Cyber (https://www.redhotcyber.com), un servizio gratuito che consente di visualizzare in tempo reale le vulnerabilità pubblicate sul National Vulnerability Database (NVD). Offre filtri per gravità e vendor, permettendo agli amministratori di individuare i problemi.

Alert pubblicati dal CSIRT Italia tra l’11 e il 12 novembre 2025: aggiornamenti di sicurezza per Ivanti e Microsoft, una patch per Zimbra e un PoC per la CVE-2025-64495 su Open WebUI.
Un servizio di rilievo internazionale è il sito VulDB (https://vuldb.com), una piattaforma statunitense che raccoglie, arricchisce e correla dati sulle vulnerabilità note, fornendo dettagli tecnici, exploit associati e indicatori di compromissione (IoC). Grazie alla collaborazione con ricercatori di tutto il mondo, aggiorna costantemente il proprio archivio e consente di tracciare l’intero ciclo di vita delle vulnerabilità. Concludiamo questa carrellata di servizi per il monitoraggio CVE con https://www.exploit-db.com/. Si tratta di un archivio pubblico di exploit, proof-of-concept e risorse per penetration tester e ricercatori, mantenuto da Offensive Security. Permette ricerche per CVE, exploit remoti e locali, shellcode e include la Google Hacking Database. Con lo
strumento SearchSploit è possibile consultare il DB offline. Fornisce statistiche, paper e feed utili per integrare intelligence e test di sicurezza nelle operazioni aziendali.

290 – Dal 10 luglio 2026!
-
RISPONDI: Recupero email hackerata
Se non lo hai ancora recuperato ma spero di si, prova c...
Di HeartBit , 2 settimane fa
-
-
RISPONDI: Fare "l'hacker" oggi è semplice
Diciamo che, attualmente (2026) si è diffusa macchia d'...
Di cyber.onions , 2 mesi fa
-
Ciao! Guarda... è molto difficile (se non quasi impossi...
Di Anonymous , 2 mesi fa
-
RISPONDI: Fare "l'hacker" oggi è semplice
Non credo che perpetrare attacchi informatici sia sempl...
Di Anonymous , 2 mesi fa
-
RISPONDI: corso valido sicurezza informatica e reti
ciao un corso sulla cybersecurity che ti posso consig...
Di Beppe62 , 3 mesi fa


-

 News5 anni fa
Hacker Journal 290
-
 News9 anni fa
Abbonati ad Hacker Journal!
-
 Articoli4 anni fa
Parrot Security OS: Linux all’italiana- La distro superblindata
-
 Articoli5 anni fa
Guida: Come accedere al Dark Web in modo Anonimo
-
 Articoli8 anni fa
Superare i firewall
-
 News7 anni fa
Le migliori Hacker Girl di tutto il mondo
-
 News9 anni fa
Iscriviti al Forum di Hacker Journal
-
 News9 anni fa
Accademia Hacker Journal