
Articoli
Tracciamo l’attività al PC
Con ActivityWatch possiamo tenere sotto controllo il tempo passato con le varie attività al nostro computer

Spesso passiamo molto tempo al PC per diverse attività e a volte ci farebbe piacere tenerne traccia, per esempio per calcolare il tempo passato a un progetto oppure anche solo per capire come trascorriamo la giornata davanti al monitor. In questo modo potremmo individuare eventuali cattive abitudini che ci fanno perdere tempo. ActivityWatch è l’utility perfetta per questo scopo: una volta installata provvede infatti a memorizzare le nostre attività e presentare in qualsiasi momento un report dettagliato, che comprende anche i periodi di inattività AFK (Away From Keyboard), cioè quando il sistema non registra movimenti del mouse o l’uso della tastiera. Inoltre sono disponibili degli add-on per Firefox e Chrome (compatibili anche con Edge) che ci permettono di visualizzare anche quanto tempo navighiamo nel Web e quali siti abbiamo visitato. Vediamo come usarlo.
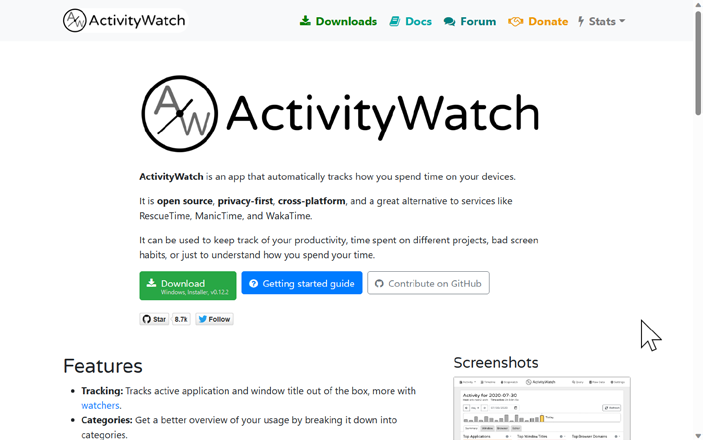
ActivityWatch è programma Open Source che possiamo scaricare dal sito activitywatch.net. È un programma crossplatform, cioè disponibile per diversi sistemi operativi: Windows, Linux, macOS. C’è anche una versione per Android.
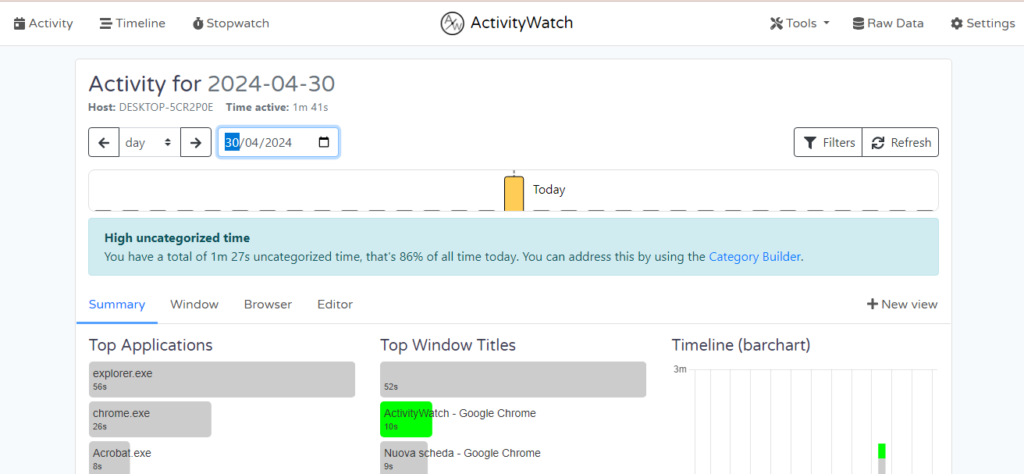
ActivityWatch integra un server Web che fornisce l’interfaccia, collegandosi dal browser all’URL localhost:5600. Dal menu accediamo al report (Activity) con le app più utilizzate o a una timeline che mostra la cronologia delle attività.
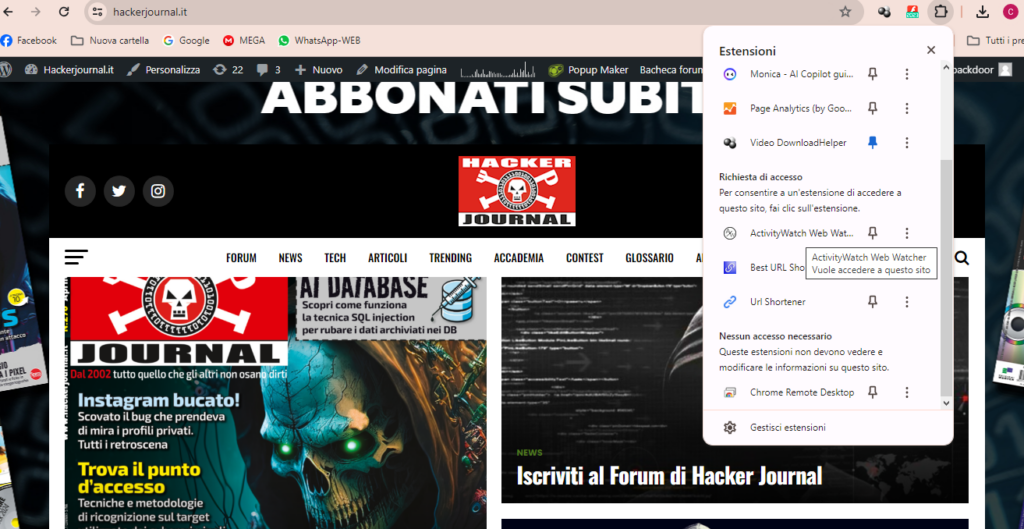
Per tracciare le attività, ActivityWatch usa i Watcher, dei software che memorizzano ciò che facciamo al PC. Sono già inclusi quello per Windows e AFK, per aggiungere quelli per i browser andiamo nei relativi store e installiamo gli add-on.
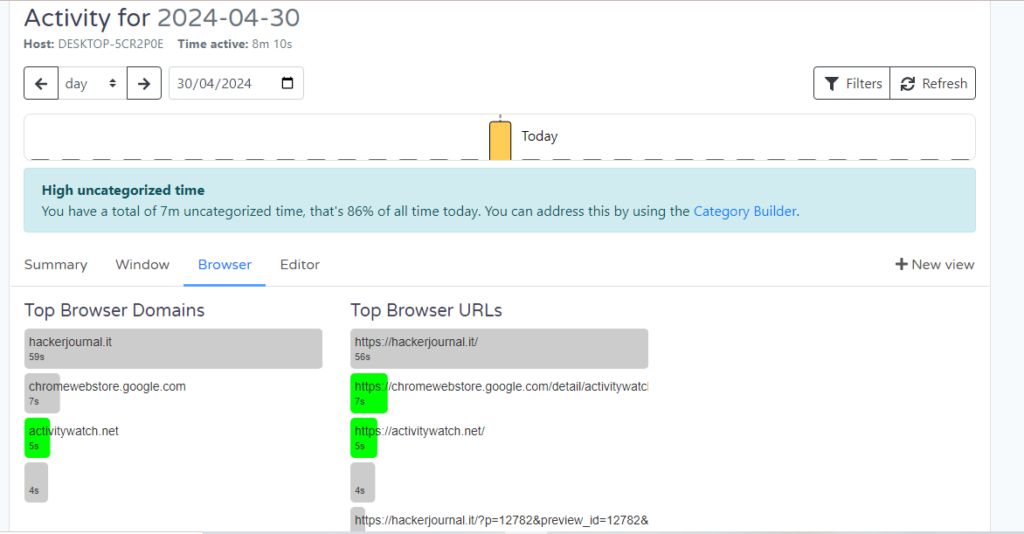
Da Activity, installato l’add-on ActivityWatch per il browser, vedremo nel dettaglio delle attività i diversi siti che abbiamo visitato e il tempo trascorso, selezionando appunto la scheda Browser. Il dettaglio sarà visibile anche nella timeline.



Concordato Preventivo R.G. P.U. 640-4/2024, Tribunale di Milano, Datamatic S.r.l. (già Datamatic S.p.A.), Commissario Giudiziale Dott. avv. Carlo Pagliughi.
Pubblicità di offerta irrevocabile pervenuta ed invito alla manifestazione di interesse ex art. 91 CCII (c.d. offerte concorrenti) da sottoporre ad eventuale successiva procedura competitiva, per la cessione della partecipazione pari al 51% del capitale sociale di Datamatic Sistemi e Servizi S.p.A. (“DSS” o “Partecipazione”), di proprietà di Datamatic S.r.l., in relazione alla quale è pervenuta proposta irrevocabile di acquisto al prezzo di Euro 550.000,00 (cinquecentocinquantamila/00)
Si invitano gli eventuali interessati a manifestare l’interesse all’acquisto della Partecipazione, per il prezzo base di Euro 550.000,00 (cinquecentocinquantamila/00). La manifestazione di interesse avente ad oggetto la Partecipazione dovrà pervenire entro e non oltre le ore 12:00 del 12 ottobre 2026 all’indirizzo pec [email protected]. Si precisa che all’indirizzo [email protected] potrà essere inviata richiesta di accesso alla Data Room, previa sottoscrizione di un accordo di riservatezza. Il presente annuncio e la ricezione di eventuali manifestazioni di interesse non comportano alcun obbligo od impegno alla alienazione nei confronti di eventuali offerenti, e per essi alcun diritto a qualsiasi titolo (mediazione o consulenza). L’invito a manifestare completo è pubblicato sul Portale delle Vendite Pubbliche e messo a disposizione a semplice richiesta.
L’annuncio completo è scaricabile cliccando qui.
Articoli
Account online dimenticati
Anche la presenza sul Web accumula “residui” da scovare ed eliminare per velocizzare il proprio sistema.
Nel tempo è facile accumulare numerosi account online: servizi provati una volta, forum tecnici, piattaforme cloud, repository o siti utilizzati per scaricare documentazione. Molti rimangono attivi anche quando non vengono più utilizzati. Il problema non è solo organizzativo ma anche di sicurezza. Per questo è utile trattare gli account online come qualsiasi altra risorsa del sistema: periodicamente vanno identificati, verificati e, se necessario, rimossi.
Come individuare gli account
Il modo più semplice per ricostruire l’elenco dei servizi a cui ci si è registrati è utilizzare la posta elettronica come archivio. La maggior parte delle piattaforme invia, infatti, messaggi automatici quando viene creato un account o quando sono effettuate operazioni sensibili come la verifica dell’indirizzo email o la reimpostazione della password. Una ricerca nella mailbox con termini tipici dei messaggi di registrazione, come “benvenuto”, “verifica il tuo indirizzo email”, “account creato” o “reimposta la password”, permette di individuare rapidamente molti servizi utilizzati negli
anni. In quelli internazionali cercate formule come “welcome”, “verify your email” o “password reset”. Se avete la posta in archivi locali potete effettuare ricerche analoghe anche dalla riga di comando. Strumenti come grep permettono di analizzare rapidamente grandi archivi con ricerche come:
grep -Ri “welcome” ~/Mail
Una volta individuato un servizio, conviene verificare alcune informazioni disponibili nella maggior parte delle piattaforme, come la data dell’ultimo accesso, l’ultima modifica della password, l’eventuale presenza di sessioni attive oppure una cronologia degli accessi recenti. Questi dati permettono di capire se l’account è stato utilizzato di recente
oppure se è rimasto inattivo per anni. Nel secondo caso è spesso più sicuro eliminarlo.
Password manager e accessi federati
Anche password manager come Bitwarden o KeePassXC permettono di visualizzare l’elenco dei servizi registrati e spesso consentono di ordinare le voci in base alla data di creazione o all’ultimo utilizzo. Potrete così individuare rapidamente servizi utilizzati anni prima, eventuali account duplicati e password ripetute, eliminando quel chen non serve. Un’attenzione particolare merita anche l’autenticazione tramite servizi esterni (Single Sign-On o SSO) con Google, GitHub o altri provider di identità. Questo meccanismo utilizza protocolli di autorizzazione che consentono a un sito di usare l’identità gestita da un’altra piattaforma. Nel tempo è facile accumulare numerose autorizzazioni di
questo tipo senza accorgersene. Potete controllare queste integrazioni nelle impostazioni di sicurezza dei principali servizi, dove di solito è presente una sezione dedicata alle applicazioni collegate o agli accessi autorizzati. Rimuovere le integrazioni non più necessarie riduce il numero di servizi che possono accedere alla vostra identità principale e
limita la superficie di esposizione.
Eliminare o neutralizzare quel che non serve
Quando un account non serve più, la soluzione migliore è eliminarlo tramite le impostazioni del servizi anche se, in alcuni casi, è necessario contattare il supporto o seguire procedure manuali. Se l’eliminazione non è possibile, potete comunque ridurre il rischio sostituendo la password con una stringa casuale generata dal password manager, rimuovendo le informazioni personali dal profilo, disattivando notifiche e integrazioni esterne e revocando eventuali token di accesso. Un controllo periodico del password manager e delle email di registrazione è spesso sufficiente per individuare account inutilizzati e ridurre progressivamente il numero di credenziali attive.
Può diventare un problema di sicurezza
Gli account vecchi spesso utilizzano password che non sono mai state aggiornate oppure credenziali riutilizzate su altri servizi. Se una di queste credenziali compare in un database compromesso, un account dimenticato può diventare un bersaglio facile per attacchi automatici di credential stuffing, nei quali le credenziali rubate vengono provate su numerosi servizi diversi. Un secondo rischio riguarda i dati personali. Molti servizi conservano informazioni, cronologie o file associati all’account anche dopo lunghi periodi di inattività. Se l’account non viene più monitorato, eventuali accessi non autorizzati possono passare inosservati.
Leggi anche: “Il portachiavi in bella mostra“
Articoli
Svuotare la RAM con criterio
Analizzare l’uso della memoria individua processi che consumano troppa RAM e provocano rallentamenti o uso eccessivo dello swap.

A differenza dello spazio su disco, la RAM non è una risorsa che deve essere mantenuta libera. Nei sistemi Linux moderni la memoria disponibile viene utilizzata in modo aggressivo per migliorare le prestazioni del sistema. Quando applicazioni e servizi non richiedono tutta la RAM installata, il kernel utilizza quella libera come page cache, cioè come area temporanea in cui conservare dati recentemente letti dal disco, riducendo significativamente i tempi di accesso ai file e alle applicazioni utilizzate più spesso. Se gli stessi dati vengono richiesti di nuovo, il sistema può recuperarli direttamente dalla memoria invece di leggerli dal disco, operazione molto più lenta. Per questo motivo è normale che gli strumenti di monitoraggio mostrino una quantità molto ridotta di RAM “libera”: è in gran parte utilizzata come cache. È importante capire che questa non è davvero occupata in modo permanente. Infatti, quando un’applicazione richiede più memoria, il kernel libera automaticamente le pagine di cache meno recenti e le rende disponibili ai nuovi processi. In altre parole, “svuotare” la RAM senza criterio potrebbe rallentare il sistema invece di migliorarlo!
Quando la memoria diventa un problema
Una situazione diversa si verifica quando uno o più processi consumano una quantità eccessiva di memoria nel tempo. Applicazioni mal configurate, servizi che accumulano dati in memoria o programmi con perdite di memoria (memory leak) possono saturare la RAM e costringere il sistema a utilizzare intensivamente lo swap, cioè l’area del disco usata come memoria di emergenza. Quando questo accade, il sistema può diventare sensibilmente più lento, perché le operazioni che normalmente avverrebbero in memoria devono essere trasferite sul disco. Nei computer desktop il sintomo più evidente è il rallentamento delle applicazioni e dell’interfaccia grafica; sui server, invece, possono aumentare i tempi di risposta dei servizi. Per questo motivo è utile controllare periodicamente l’uso della memoria e verificare se qualche processo stia crescendo in modo anomalo. A differenza della cache del filesystem, che viene gestita automaticamente dal kernel, il consumo di memoria da parte dei processi è un indicatore diretto del comportamento delle applicazioni in esecuzione: non trascuratela!
Analisi in tempo reale
Ci sono diversi strumenti per osservare in tempo reale come viene utilizzata la memoria del sistema, distinguendo tra quella usata dai processi, quella impiegata come cache e l’eventuale uso dello swap. Uno dei comandi più semplici è:
free -h
La colonna available che mostra è molto utile perché rappresenta la quantità di memoria che può essere allocata immediatamente senza ricorrere allo swap. Per analisi più dettagliate è possibile utilizzare strumenti interattivi come top o htop, che permettono di osservare i processi in esecuzione e ordinarli in base al consumo di memoria. In top è sufficiente premere il tasto M per ordinare l’elenco dei processi in base alla RAM utilizzata. Htop offre inoltre un’interfaccia più leggibile e permette di filtrare facilmente i processi più pesanti. Un altro strumento utile è vmstat, che fornisce informazioni sul comportamento della memoria virtuale e sullo stato dello swap:
vmstat 5
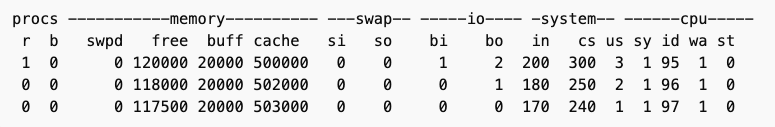
L’intervallo di aggiornamento (in questo caso 5 secondi) permette di osservare nel tempo l’andamento dell’uso della memoria e l’eventuale attivazione dello swap. L’output sarà simile a quello mostrato qui sotto, con aggiornamenti periodici delle principali statistiche del sistema: stato della memoria, attività dello swap, operazioni di I/O e utilizzo della CPU. Potrete così verificare rapidamente se l’utilizzo della memoria rientra nel comportamento normale del sistema o se indica un problema da approfondire.
Articoli
A caccia di pacchetti e residui di sistema
Individuate facilmente cache, dipendenze inutilizzate e kernel obsoleti in modo da recuperare spazio prezioso.

Durante l’installazione o l’aggiornamento del software, i gestori di pacchetti scaricano gli archivi dei programmi e le librerie necessarie. Li conservano poi nella propria cache per evitare di dover rifare il download in caso di reinstallazioni o aggiornamenti successivi. Nei sistemi basati su Debian e Ubuntu, per esempio, i pacchetti scaricati vengono salvati nella directory /var/cache/apt/archives. Ogni aggiornamento del sistema scarica nuove versioni dei pacchetti dai repository, ma quelle precedenti possono rimanere archiviate nella cache. Anche su sistemi aggiornati regolarmente questo significa che, con il passare dei mesi, la directory può crescere molto. Non è raro, infatti, trovare centinaia di megabyte o diversi gigabyte di file .deb che non sono più necessari per il funzionamento del sistema. APT offre diversi comandi per gestire questa situazione. Il più diretto è:
sudo apt clean
che elimina completamente i pacchetti presenti nella cache. Un approccio più conservativo consiste invece nell’utilizzare:
sudo apt autoclean
che rimuove solo i pacchetti ormai obsoleti, cioè quelli che non sono più disponibili nei repository configurati. Strumenti analoghi esistono anche in altre distribuzioni: dnf clean all nei sistemi Fedora o pacman -Sc nei sistemi Arch permettono di ottenere risultati simili. La pulizia periodica della cache non influisce sul software installato ma può recuperare spazio in modo immediato.
Dipendenze inutilizzate e pacchetti orfani
Un’altra fonte di residui sono le dipendenze installate automaticamente. Quando si installa un’applicazione tramite il gestore di pacchetti, questa porta con sé anche le librerie e i componenti necessari al suo funzionamento. Questo meccanismo semplifica la gestione del software, ma può lasciare nel sistema elementi che non servono più dopo la rimozione del programma principale. Nel tempo possono così accumularsi pacchetti installati come dipendenze ma non più richiesti da alcun software presente nel sistema. Questi componenti vengono spesso chiamati pacchetti orfani o dipendenze inutilizzate. In Debian, Ubuntu e Fedora, le dipendenze non più necessarie possono essere rimosse direttamente dal gestore di pacchetti con il comando autoremove. Il sistema analizza l’elenco dei pacchetti installati automaticamente e rimuove quelli che non risultano più richiesti da alcun software presente. Su Arch Linux i pacchetti orfani possono invece essere individuati con pacman -Qtd. Ridurre il numero di componenti installati non ha effetti solo sullo spazio disco: un sistema con meno pacchetti è anche più semplice da aggiornare.
Kernel vecchi e componenti storici
Molte distribuzioni mantengono anche più versioni del kernel installate, così, se un aggiornamento introduce problemi di compatibilità con hardware o driver, è possibile avviare il sistema con una versione precedente funzionante. Ogni kernel installato include però diversi file: la sua immagine, i moduli caricabili e l’initramfs utilizzato durante l’avvio, che finiscono con l’accumularsi. Nei sistemi Debian e Ubuntu la rimozione dei kernel obsoleti è spesso gestita automaticamente proprio dal comando apt autoremove, che mantiene quella corrente e una precedente per sicurezza. Altrimenti, potete verificare manualmente quali versioni sono installate:
dpkg –list | grep linux-image
Prima di rimuovere manualmente un kernel, però, verificate quale versione è attualmente in uso:
uname -r
Ricordatevi, comunque, di tenere almeno una versione precedente del kernel per poter ripristinare in caso di problemi dopo un aggiornamento.

Un attacco DDoS è, nella sua definizione minima, il tentativo di rendere un servizio indisponibile ai suoi utenti legittimi saturando una risorsa finita. La formula resta volutamente generica, perché la risorsa cambia di volta in volta: può essere la banda del collegamento, la tabella delle connessioni semiaperte del kernel, il numero di processi PHP disponibili, il pool di connessioni verso il database. Quello che accomuna i casi non è il volume del traffico, ma il rapporto tra costo di generazione e costo di elaborazione: chi attacca spende pochissimo per produrre una richiesta che al bersaglio costa molto. Da qui nasce anche l’equivoco più diffuso, cioè l’idea che disporre di risorse elastiche basti a far evaporare il problema.
Due attacchi con lo stesso nome
Sotto la stessa sigla convivono due famiglie che hanno poco in comune. La prima agisce ai livelli 3 e 4: SYN flood, flood UDP e soprattutto attacchi di amplificazione, che sfruttano servizi mal configurati e raggiungibili da Internet (resolver DNS aperti, NTP, istanze memcached esposte) per moltiplicare di decine o centinaia di volte il traffico generato dalla botnet. Qui l’anomalia è evidente e si affronta con criteri di rete: il pacchetto va scartato prima di arrivare al server.
La seconda famiglia agisce al livello applicativo e non ha nulla di anomalo da esibire. Sono richieste HTTP formalmente corrette, con handshake TLS completato, header plausibili e spesso indirizzi residenziali presi in prestito da una botnet domestica. Il volume può fermarsi a poche migliaia di richieste al secondo, un’inezia in termini di banda, purché siano indirizzate agli endpoint giusti: la ricerca interna, il carrello, xmlrpc.php, una query string sempre diversa che rende inservibile qualunque cache. Una richiesta da quattrocento byte può costare al bersaglio una query non indicizzata su una tabella da due milioni di righe.
Valutare un cloud hosting sullo spazio disco e sulla versione di PHP è la parte facile, e le due righe che contano stanno altrove (a quale livello della rete opera il filtro e come viene contabilizzato il traffico in eccedenza). Vhosting, per restare agli operatori italiani, ha costruito la propria infrastruttura su datacenter ridondati in Italia con mitigazione gestita a monte del nodo; altri demandano il compito a un servizio di terze parti da attivare a parte. Sono due modelli diversi e la differenza si apprezza un giorno solo.
Il conto al posto del downtime
L’elasticità funziona, nel senso che fa quello che promette: aggiunge worker, istanze, container. Il punto è che non elimina l’attacco, ne cambia la valuta. Un flood applicativo contro un’architettura che scala non produce più un errore 503, produce una fattura. Il fenomeno ha un nome proprio, EDoS, Economic Denial of Sustainability, e per chi attacca ha il vantaggio di non essere immediatamente visibile: il sito risponde, i grafici del monitoraggio restano verdi, il danno emerge a fine mese.
L’elasticità, per giunta, ha un fondo. Si scalano i frontend con relativa facilità, non altrettanto il livello dati: il pool di connessioni resta un numero finito e, quando i worker appena aggiunti si accodano tutti sullo stesso database, il collo di bottiglia si sposta senza allargarsi. Scalare sotto attacco significa quasi sempre pagare di più per cedere un po’ più tardi.
Dove si ferma davvero
Il traffico ostile va scartato dove eliminarlo costa poco, cioè il più a monte possibile. Una rete anycast disperde il volume su decine di punti di presenza invece di convogliarlo su un singolo collegamento; i centri di scrubbing separano il traffico legittimo da quello di attacco prima che raggiunga l’origine; sul fronte applicativo servono limiti di frequenza per indirizzo e per sistema autonomo, e sfide computazionali che rendono l’attacco costoso anche per chi lo conduce.
Vale la pena conoscere anche la procedura che scatta quando questa catena non c’è. Di fronte a un volumetrico che minaccia il collegamento condiviso, l’operatore di rete a monte annuncia via BGP che il traffico diretto a quell’indirizzo va scartato: è il blackholing, e funziona benissimo. Non protegge il cliente, protegge la rete dagli effetti collaterali del cliente, portando a termine l’attacco con mezzi propri.
Cosa resta al proprio livello
Sul server ci sono comunque interventi sensati, a patto di sapere che filtrare a valle consuma comunque la banda in ingresso. I moduli di rate limiting di Nginx (limit_req, limit_conn) contengono i picchi per client; una cache di pagina intera che risponde senza toccare né PHP né database sposta il tetto di parecchio, perché una pagina servita dalla cache costa tre ordini di grandezza meno di una generata a ogni richiesta; normalizzare o ignorare le query string sconosciute evita che la cache venga aggirata con un parametro casuale; disattivare endpoint legacy come xmlrpc.php toglie di mezzo un bersaglio classico.
Da misurare prima, non durante
Nota pratica: il lavoro utile si fa a freddo. Serve sapere quante richieste al secondo regge il sito con la cache attiva e quante senza, quali endpoint non sono cacheabili per costruzione, e a chi va inoltrata la richiesta di mitigazione — con i contatti del provider annotati da qualche parte che non sia il sito stesso, che durante un attacco è esattamente la cosa che non risponde.

La sicurezza di un progetto online non dipende soltanto dalla qualità del codice o dall’affidabilità del servizio di hosting. Un sito può funzionare perfettamente dal punto di vista dell’utente e, allo stesso tempo, presentare vulnerabilità di sicurezza che potrebbero essere sfruttate per accedere a informazioni riservate, modificare contenuti o compromettere l’intera infrastruttura.
Verificare periodicamente lo stato di sicurezza permette di individuare eventuali problemi prima che possano trasformarsi in incidenti. La verifica dovrebbe riguardare sia l’applicazione web sia il server, il CMS, i plugin, i database e le modalità con cui vengono gestiti gli accessi. Un’attività di controllo ben strutturata può quindi diventare una componente essenziale della gestione del sito web, soprattutto per portali aziendali, e-commerce e servizi che raccolgono dati degli utenti.
Conoscere i principali punti deboli di un sito
Una verifica efficace dovrebbe partire dalla comprensione delle aree nelle quali possono comparire problemi. Le vulnerabilità possono dipendere da errori nella programmazione, configurazioni non corrette, componenti non aggiornati o sistemi di autenticazione insufficientemente protetti. Anche un sito relativamente semplice può essere esposto se utilizza un software obsoleto o dispone di funzionalità non configurate correttamente.
Particolare attenzione merita la gestione degli input forniti dagli utenti, ad esempio attraverso moduli di contatto, campi di ricerca, aree riservate e sistemi di login. Una validazione insufficiente dei dati può aumentare il rischio di attacchi rivolti all’applicazione.
Altrettanto rilevante è la gestione delle credenziali. Password deboli, account amministrativi non più utilizzati e assenza di sistemi di autenticazione aggiuntivi possono ampliare la superficie di attacco. Una buona analisi parte quindi dalla mappatura delle funzionalità disponibili e dalla valutazione dei potenziali punti di ingresso.
Aggiornamenti e configurazione rappresentano il primo controllo
CMS, plugin, temi, librerie e componenti del server dovrebbero essere mantenuti costantemente aggiornati. Le nuove versioni di un software non introducono soltanto funzionalità, ma possono contenere correzioni relative a vulnerabilità scoperte dopo la pubblicazione delle versioni precedenti.
Un sito realizzato con WordPress, Joomla, Drupal o altri CMS richiede quindi una particolare attenzione agli aggiornamenti di sicurezza. La presenza di un plugin abbandonato dal suo sviluppatore può costituire un rischio anche se tutte le altre componenti sono aggiornate.
La configurazione del server merita la stessa attenzione. Permessi dei file troppo permissivi, directory accessibili senza necessità, servizi inutilizzati lasciati attivi e messaggi di errore eccessivamente dettagliati possono fornire informazioni utili a un potenziale aggressore. Anche la corretta implementazione del certificato HTTPS e delle impostazioni del server contribuisce a ridurre il rischio.
Utilizzare uno scanner per individuare possibili vulnerabilità
L’analisi manuale rimane preziosa, ma può essere affiancata da strumenti automatici capaci di esaminare numerosi elementi del sito in tempi relativamente brevi. Un vulnerability scanner analizza l’applicazione alla ricerca di configurazioni problematiche, componenti esposti e comportamenti che potrebbero indicare la presenza di falle.
In questo ambito esistono diversi software diventati standard di fatto per l’analisi della sicurezza. Strumenti come OWASP ZAP e Burp Suite agiscono come proxy di intercettazione, consentendo di analizzare e modificare il traffico HTTP/HTTPS in tempo reale per individuare falle logiche e vulnerabilità come SQL Injection o Cross-Site Scripting (XSS). Per controlli più rapidi e mirati sul web server, utility da riga di comando come Nikto permettono di scansionare automaticamente configurazioni errate, file pericoli e software obsoleti, mentre tool quali Nuclei sfruttano template personalizzabili per identificare CVE recenti su larga scala.
Tra i servizi gratuiti disponibili spicca ZAPScanner, uno strumento sviluppato dal gruppo tedesco binsec che automatizza l’analisi della superficie di attacco basandosi sul motore open source OWASP ZAP. Per garantire un utilizzo etico e sicuro, la piattaforma richiede l’autenticazione dell’utente e l’inserimento di un record DNS TXT sul dominio target per autorizzare esplicitamente la scansione. Questo approccio permette di identificare in modo sistematico le vulnerabilità dell’applicazione web senza eseguire attacchi distruttivi non autorizzati.
Il risultato di una scansione deve comunque essere interpretato con attenzione. Gli strumenti automatici possono produrre segnalazioni che richiedono ulteriori verifiche prima di essere considerate problemi reali. Per questo motivo è opportuno analizzare ogni elemento rilevato, stabilirne il livello di gravità e intervenire prima sulle vulnerabilità che presentano il rischio maggiore.
Controllare accessi, password e privilegi
La protezione dell’area amministrativa rappresenta uno degli aspetti centrali della sicurezza di un sito. Gli account dovrebbero essere concessi soltanto alle persone che ne hanno realmente necessità, applicando il principio del privilegio minimo. Un collaboratore incaricato esclusivamente della pubblicazione dei contenuti, ad esempio, non dovrebbe necessariamente disporre degli stessi permessi dell’amministratore del sistema.
Le password devono essere sufficientemente lunghe, difficili da prevedere e differenti da quelle utilizzate su altri servizi. Nei sistemi che lo consentono è consigliabile attivare anche l’autenticazione a due fattori, soprattutto per gli account dotati di privilegi elevati.
Occorre verificare periodicamente anche l’elenco degli utenti registrati. Account appartenenti a ex collaboratori o profili creati temporaneamente e successivamente dimenticati possono rappresentare punti di accesso non più necessari. Una corretta gestione dei privilegi riduce sensibilmente le possibilità che una singola credenziale compromessa consenta un accesso esteso all’infrastruttura.
Verificare backup, log e sistemi di monitoraggio
Prevenire un attacco è l’obiettivo principale, ma nessun sistema può essere considerato completamente immune da problemi. Per questa ragione una strategia di sicurezza dovrebbe includere procedure che consentano di individuare rapidamente comportamenti anomali e ripristinare il servizio in caso di necessità.
I log di sistema possono fornire indicazioni preziose su tentativi di accesso ripetuti, richieste sospette, errori insoliti o modifiche non autorizzate. La loro analisi permette di riconoscere segnali che una semplice visita al sito non renderebbe visibili.
Anche i backup devono essere sottoposti a verifiche. Non basta creare periodicamente una copia dei file e del database: occorre assicurarsi che sia completa, accessibile e realmente utilizzabile per un eventuale ripristino. Conservare almeno una copia separata dall’infrastruttura principale aumenta inoltre la resilienza del sito nel caso in cui il server venga compromesso.
Rendere i controlli di sicurezza un’attività periodica
Una scansione effettuata una sola volta offre soltanto una fotografia del sito in un determinato momento. Nuovi plugin, modifiche al codice, aggiornamenti del server e funzionalità aggiunte possono introdurre successivamente ulteriori punti deboli. La verifica delle vulnerabilità dovrebbe quindi essere integrata nelle normali attività di manutenzione.
La frequenza dei controlli può variare in funzione della complessità del progetto. Un sito aziendale che viene modificato raramente presenta esigenze differenti rispetto a un e-commerce aggiornato quotidianamente o a una piattaforma che gestisce migliaia di utenti. In tutti i casi, programmare controlli periodici permette di accorciare il tempo che intercorre tra la comparsa di un problema e la sua individuazione.
L’approccio più efficace combina aggiornamenti, configurazioni corrette, scansioni automatiche, verifiche manuali, monitoraggio e procedure di ripristino. La sicurezza informatica diventa così un processo continuo e non un intervento occasionale eseguito soltanto dopo la comparsa di un problema.
Articoli
Recuperate spazio con i log di sistema
Analizzate lo spazio occupato, ripulite il journal di systemd e configurate la rotazione automatica per evitare accumuli inutili.

Per mantenere un sistema pulito è importante controllare regolarmente i log. Nelle distribuzioni moderne i messaggi possono trovarsi sia nei file testuali sotto /var/log sia nel systemd journal gestito da journald, quindi lo spazio occupato non è concentrato in un solo punto. La directory /var/log resta comunque il primo luogo da ispezionare. Qui vengono salvati, a seconda della distribuzione e dei servizi installati, i log del kernel, dell’autenticazione, del gestore di pacchetti, del server grafico o dei demoni di rete. Alcuni file sono attivi, altri sono archivi già ruotati e compressi. Per individuare rapidamente dove si concentra l’occupazione, conviene misurare la dimensione delle sottodirectory e dei file più pesanti, per esempio con:
sudo du -sh /var/log/*
Se emerge una crescita anomala, è bene verificare se dipende da un servizio che sta producendo errori in modo continuo, da un debug rimasto attivo o da una configurazione troppo permissiva. La logica corretta non è cancellare alla cieca, ma capire quali componenti stanno generando dati e se quei dati hanno ancora utilità operativa. Un file enorme in /var/log non è solo un problema di spazio: spesso indica un malfunzionamento o una configurazione da correggere.
Journald: capire quanto occupa e come ridurlo
Nei sistemi che usano il sistema di init systemd, journald raccoglie eventi del kernel, dei servizi e di molte componenti dell’avvio e della gestione ordinaria. A differenza dei log testuali classici, usa un formato binario interrogabile con journalctl. Prima di intervenire conviene usare:
journalctl –disk-usage
che restituisce la dimensione complessiva dei file del journal e permette di capire effettivamente se l’archivio è diventato un candidato reale per la pulizia. Per ridurne l’ingombro senza azzerarlo esistono due approcci molto utili. Il primo è basato sull’età dei messaggi:
sudo journalctl –vacuum-time=7d
In questo modo vengono mantenuti solo gli eventi degli ultimi sette giorni. Il secondo è basato sulla dimensione totale del journal:
sudo journalctl –vacuum-size=500M
Qui il journal viene ridotto fino a occupare al massimo 500 MB. Sono due strategie diverse e vanno scelte in base all’uso del sistema. Su una workstation personale può essere sensato conservare soltanto pochi giorni di cronologia; su una macchina usata per test, sviluppo o amministrazione di servizi conviene spesso ragionare in termini di spazio massimo, così da preservare una quantità sufficiente di storico senza lasciare che la crescita diventi incontrollata.
C’è poi da fare una distinzione importante tra log persistenti e log volatili. Se il sistema salva il journal in /var/log/journal, i dati restano disponibili anche dopo il riavvio. Se invece questa directory non viene usata, il journal può essere mantenuto solo in memoria o in aree temporanee e quindi andare perduto alla successiva accensione. La modalità persistente è preziosa per la diagnosi, ma proprio per questo richiede più attenzione nella
gestione dello spazio.
Evitare che i file crescano senza limite
Logrotate gestisce la rotazione dei log testuali tradizionali. Quando un file raggiunge determinate dimensioni o età, viene archiviato, rinominato, spesso compresso e sostituito da un nuovo file attivo, evitando che i log crescano indefinitamente. La configurazione globale si trova normalmente in /etc/logrotate.conf, mentre le regole specifiche per i singoli servizi sono raccolte in /etc/logrotate.d/. È utile verificare queste impostazioni soprattutto quando un servizio genera grandi quantità di log o quando delle applicazioni aggiungono nuovi file senza una politica di rotazione adeguata. Delle configurazioni troppo conservative possono accumulare molti archivi compressi, mentre delle impostazioni troppo aggressive rischiano di eliminare informazioni utili per il troubleshooting. Ricordatevi che logrotate e journald svolgono funzioni diverse e complementari: il primo gestisce i file testuali in /var/log, il secondo l’archivio binario del journal. Per mantenere sotto controllo l’uso dello spazio vanno quindi considerati entrambi.
Da sapere
Se il journal tende a crescere troppo, conviene intervenire anche in modo permanente modificando /etc/systemd/ journald.conf. Le direttive più utili sono quelle che impongono un tetto allo spazio usato, come per esempio SystemMaxUse, oppure limiti dedicati ai soli dati persistenti e volatili. Dopo la modifica è necessario riavviare il
servizio con: sudo systemctl restart systemdjournald.
Evitate così di dover ricorrere periodicamente a pulizie manuali e rendete prevedibile la crescita del journal, specie sui sistemi con partizioni piccole o con SSD da preservare.
*Illustrazione progettata da Magnific

290 – Dal 10 luglio 2026!
-
poi utilizzare una vpn oggi sono disponibile di per tut...
Di Redjolly , 2 settimane fa
-
RISPONDI: Recupero email hackerata
Se non lo hai ancora recuperato ma spero di si, prova c...
Di HeartBit , 4 settimane fa
-
-
RISPONDI: Fare "l'hacker" oggi è semplice
Diciamo che, attualmente (2026) si è diffusa macchia d'...
Di cyber.onions , 2 mesi fa
-
Ciao! Guarda... è molto difficile (se non quasi impossi...
Di Anonymous , 3 mesi fa
-
RISPONDI: Fare "l'hacker" oggi è semplice
Non credo che perpetrare attacchi informatici sia sempl...
Di Anonymous , 3 mesi fa


L’anomalia delle app Early Access

Cosa cambia con la direttiva NIS2

ConfSec 2026 accende il dibattito sulla cyber sicurezza

Datamatic: annuncio di vendita
Account online dimenticati

Come verificare le vulnerabilità di un sito web

La botnet che usa le connessioni domestiche

Phishing e Intelligenza Artificiale

Bluesky colpita da un attacco DDoS

Perché aggiungere risorse non ferma un attacco DDoS
-

 News5 anni fa
Hacker Journal 291
-
 News9 anni fa
Abbonati ad Hacker Journal!
-
 Articoli4 anni fa
Parrot Security OS: Linux all’italiana- La distro superblindata
-
 Articoli5 anni fa
Guida: Come accedere al Dark Web in modo Anonimo
-
 Articoli8 anni fa
Superare i firewall
-
 News7 anni fa
Le migliori Hacker Girl di tutto il mondo
-
 News9 anni fa
Iscriviti al Forum di Hacker Journal
-
 News9 anni fa
Accademia Hacker Journal